понедельник, 13 ноября 2023 г.

Настроить окружение для работы с OpenCL не просто, а очень просто

Самое сложное - это было установить собственно сам SDK, который у каждого производителя видеокарт свой (у меня NVidia). У меня это получилось, когда я скачал 2-гиговый standalone-инсталлятор и убрал там пару пунктов (кажется это были NSight Visual Studio Edition и еще CUDA Integration to Visual Studio, но тут каждый должен сам экспериментировать). После того, как это получилось, будет установлена переменная окружения CUDA_PATH, которая указывает на корень папки с необходимыми бинарными файлами и заголовками, например что-то типа "C:\Program Files\NVIDIA GPU Computing Toolkit\CUDA\v10.0":


Теперь создаем простой консольный проект в Visual Studio и настраиваем его. Сначала добавляем папку с библиотеками (не забываем, что для x64 и Win32 сборок это разные папки):


Потом указываем библиотеку OpenCL.lib:


И добавляем папку с заголовочными файлами:


Вот и все, настройка завершена! Теперь можно собрать какое-то OpenCL-приложение, например такое:


четверг, 26 октября 2023 г.

Потоки надо обеспечивать непрерывными данными для максимальной скорости

 Сделал небольшой тест. Мы берем массив точек и поворачиваем их вокруг какой-то оси в трехмерном пространстве путем перемножения матрицы вращения на точку. Умножение матрицы вращения на 90 град вокруг z-оси на точку (1, 0, 0) в 3d выглядит так: 


И матрица вращения вокруг произвольной оси (углы по осям X,Y, Z):
подробнее здесь. 

Самое интересное начивается, когда мы, ускоряя процесс вычислений, распаллеливаем их между потоками. У нас в стандартной библиотеке thread есть функция std::thread::hardware_concurrency(), которая возвращает количество логических процессоров (с учетом HT/SMT). Между ними мы и делим данные, чтобы каждый поток обрабатывал свой кусочек. Это можно сделать двумя способами. Первый способ: каждый поток имеет айди от 0 до N-1, где N - это количество логических процессоров (то, что возвращает ф-я std::thread::hardware_concurrency), тогда мы можем давать каждому потоку весь массив и он будет обрабатывать в нем элемент, соотв. своему айди. То есть в каждой порции данных поток выбирает свой элемент и его обрабатывает. Можно улучшить этот способ путем обработки каждым потоком не одного элемента, а сразу многих. Выглядит это в коде вот так:

void applyToPoints(std::vector<Point3f>& points, const int elemCnt, PointFunc func, 
                           const unsigned int thrCnt = std::thread::hardware_concurrency())
{
    std::vector<std::thread> workers;
    for (int thrId = 0; thrId < thrCnt; ++thrId)
    {
        workers.push_back(std::thread([thrId, thrCnt, elemCnt, &points, &func]()
        {
            for (int i = thrId * elemCnt; i < vectSize; i += thrCnt * elemCnt)
            {
	        int blockEndIdx = std::min(i + elemCnt, (int)vectSize);
	        for (int j = i; j < blockEndIdx; ++j)
	        {
	            func(points[j]);
		}
	    }
        }));
    }
 
    for (std::thread& t : workers)
    {
        t.join();
    }
    workers.clear();
}

Второй способ: мы делим весь массив на равные части и "скармливаем" каждую часть своему потоку и он уже непрерывно обрабатывает все элементы:

void applyToPoints2ndWay(std::vector<Point3f>& points, PointFunc func, 
                          const unsigned int thrCnt = std::thread::hardware_concurrency())
{
    auto start = std::chrono::steady_clock::now();
    std::vector<std::thread> workers;
    size_t rod = points.size() % thrCnt;
    auto thrItemCnt = (points.size() - rod) / thrCnt;
    for (int thrId = 0; thrId < thrCnt; ++thrId)
    {
	workers.push_back(std::thread([thrId, thrCnt, thrItemCnt, &points, &func]()
  	    {
		auto begIdx = thrId * thrItemCnt;
		bool isLastThread = (thrId == thrCnt - 1);
		auto endIdx = isLastThread ? points.size() : begIdx + thrItemCnt;
		for (auto i = begIdx; i < endIdx; ++i)
		{
		    func(points[i]);
		}
	    }));
    }
 
    for (std::thread& t : workers)
    {
	t.join();
    }
    workers.clear();
}
Теперь посмотрим на результаты:

-- create array..
-- create array done!
-- init array:
threads: 16, block size:  225000000 bytes, time: 2.15009
threads:  8, block size:  450000000 bytes, time: 2.77854
-- init array done!
-- 1st way: many small blocks:
threads:  1, block size:         12 bytes, time: 2.31308
threads: 16, block size:         12 bytes, time: 1.00347
threads: 16, block size:         96 bytes, time: 0.575906
threads: 16, block size:       1536 bytes, time: 0.39477
threads: 16, block size:      12288 bytes, time: 0.348051
threads: 16, block size:     122880 bytes, time: 0.324958
-- 2st way: the biggest blocks:
threads: 16, block size:  225000000 bytes, time: 0.338135
threads:  8, block size:  450000000 bytes, time: 0.340936
threads:  4, block size:  900000000 bytes, time: 0.593947
threads:  2, block size: 1800000000 bytes, time: 1.14009
Обращают на себя внимание несколько моментов. 
Во-первых, если каждый поток обрабатывает за одну итерацию только один элемент массива (12 байт), то 16 потоков работают с такой же скоростью, как 2 потока, каждый из которых обрабатывает свой массив полностью. Ну или 16 потоков, каждый из которых за одну итерацию обрабатывает по 8 элементов (96 байт) равны по производительности 4 потокам, каждый из которых обрабатывает свою часть массива. И так далее. Видно, что скорости работы обоих алкгоритмов почти сравниваются где-то между 128 элементами (1.5 килобайта) и 1024 элементами (12 килобайт) за одну итерацию. То есть ядрам процессора лучше скармливать достаточно крупные непрерывные блоки данных размером больше килобайта, чтобы они минимально ждали, пока будет доставлен следующий блок из памяти. 
Во-вторых, как по-разному работает технология SMT в разных задачах. Для основной задачи - умножения матрицы на точку - разницы между 8 и 16 потоками почти нет. А вот для вспомогательной задачи - инициализация массива - SMT работает в 1.3 раза быстрее (2.15 сек при 16 потоках и 2.78 при 8 потоках). Не очень понимаю, почему именно так, но вот.

Исходный код здесь. Тестовая платформа: Ryzen7 3700X, 16GB RAM.

понедельник, 23 октября 2023 г.

Простенький тест скорости работы shared_ptr vs raw ptr.

 Всегда было интересно, насколько дорого обходятся умные указатели, потому решил написать простенький тест, чтобы проверить насколько все хорошо или плохо. Для сравнение взял три разные структуры: классическиую структуру, структуру с raw-pointers и структуру с shared_ptr.  

Сценарий такой: создаем и инициализируем массив обьектов, сортируем его, потом считываем его для вычисления средних значений и печатаем результаты и замеры времени исполнения. Код структур:

struct StudentId
{
	char str[20];
};
 
struct StudentMarks
{
	int math;
	int it;
	int lit;
	int pe;
};
 
struct RecommendLetters
{
	int amount;
};
 
// plain struct
struct StudentInfo 
{
	StudentId id;
	StudentMarks marks;
	RecommendLetters letters;
};
 
// raw-pointer struct
struct StudentInfoRP
{
	StudentInfoRP()
	{
		id = new StudentId();
		marks = new StudentMarks();
		letters = new RecommendLetters();
	}
 
	~StudentInfoRP()
	{
		delete id;
		delete marks;
		delete letters;
	}
 
	StudentId* id;
	StudentMarks* marks;
	RecommendLetters* letters;
};
 
// shared pointers struct
struct StudentInfoSP
{
	std::shared_ptr<StudentId> id = std::make_shared<StudentId>();
	std::shared_ptr<StudentMarks> marks = std::make_shared<StudentMarks>();
	std::shared_ptr<RecommendLetters> letters = std::make_shared<RecommendLetters>();
};
Инициализация выглядит так:

std::vector<StudentInfo> studs(amount);
for (int i = 0; i < amount; ++i)
{
        StudentInfo& stud = studs[i];
        sprintf_s(stud.id.str, sizeof(stud.id) / sizeof(char), "%03d-%014d", rand() % 100, i);
        stud.marks.math = rand() % 10;
	stud.marks.it = rand() % 10;
	stud.marks.lit = rand() % 10;
	stud.marks.pe = rand() % 10;
	stud.letters.amount = (rand() % 20 == 5) ? rand() % 4 : 0;
}
Сортировка:

std::sort(studs.begin(), studs.end(), [](const StudentInfo& a, const StudentInfo& b)
{
	if (a.marks.math != b.marks.math)
	{
        	return a.marks.math < b.marks.math;
	}
	else if (a.marks.it != b.marks.it)
	{
		return a.marks.it < b.marks.it;
	}
	else if (a.marks.lit != b.marks.lit)
	{
		return a.marks.lit < b.marks.lit;
	}
	else if (a.marks.pe != b.marks.pe)
	{
		return a.marks.pe < b.marks.pe;
	}
	else if (a.letters.amount != b.letters.amount)
	{
		return a.letters.amount < b.letters.amount;
	}
	else if (strcmp(a.id.str, b.id.str) != 0)
	{
		return strcmp(a.id.str, b.id.str) < 0;
    	}
});
В общем, ничего необычного. Аналогично все и для других двух структур, только там , посколько это указатели, обращение идет через стрелку. Время засекал очень просто:

auto start = std::chrono::steady_clock::now();
std::vector<StudentInfo> studs(amount);
 
// do some..
 
auto end = std::chrono::steady_clock::now();
const std::chrono::duration<double> delta = end - start;
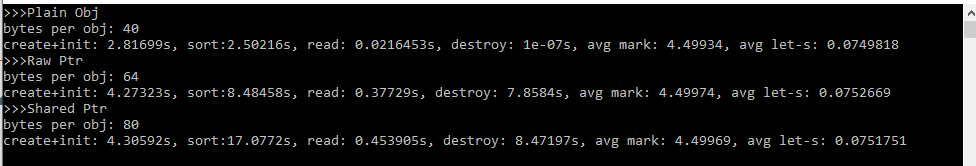
Теперь самое интересное - результаты. Вот они:


Как видно, вот всех дисциплинах убедительную победу одержал вариант с простыми структурами, значительно опередив вариант с raw-pointer и shared-pointer, причем сортировка была быстрее многократно, чтение значений быстрее на порядок, а удаление обьектов вообще в тысячи раз быстрее. Если ваши данные скомпонованы подряд, компактно в памяти и вы обращаетесь к ним напрямую, а не не через ссылку/указатель - то это путь к высокой скорости! Но нас интересует разница между сырыми указателями и умными указателями - она на самом деле оказалась не так и значительна: сортировка 10 миллионов элементов raw-pointer оказалась всего в 2 раза быстрее, чем сортировка shared-pointer. Создание и удаление и тех и других почти не отличается. 

Вывод: отказ от умных указателей не даст вам значительного прироста производительности, ну кроме каких-то очень-очень специальных случаев.

P.S.
Код находится здесь. Тестовая платформа: Ryzen 7 3700X, 16GB RAM

вторник, 27 октября 2020 г.

"Fluid Painter" by David Li

Натыкаешься на такое иногда и только присвистнуть можешь восхищенно:


Попробовать можно здесь.

Но, как оказалось, там сломалась кнопка Save. Разбирающиеся в вебе люди даже зашли на гитхаб с проектом и предложили исправления, но автор, сделавший последний коммит 4 года назад, очевидно уже давно забыл про свой проект и предложенные исправления не смержил с веткой. Я же очень захотел запустить его у себя в полностью работоспособном варианте. Оказывается, что Chrome уже не поддерживает запуск веб-запросов непосредственно с диска и поэтому, если просто открыть страницу index.html в браузере, то работать ничего не будет. Пришлось ставить node.js (он небольшой, к счастью) и доставить к нему веб-сервер:

npm install http-server -g

и потом в корне проекта (скачанного с гитхаба и подправленного, конечно - искать в "pull request" коммит "Fix Save Button") запустить его:

http-server -c-1 

Доступ к рисовалке через бразузер:

 http://127.0.0.1:8080


Ради такой красоты стоило повозиться пару часов.


понедельник, 19 октября 2020 г.

Размеры исходных файлов

 Игра, которая после билда занимает на жестком диске 60 гигабайт, превращается в apk-пекедж для андроида весом 47 мегабайт. Как так вообще получается-то? Нет, ну я конечно понимаю, откуда оно все взялось и зачем и для чего, но все равно, как-то это... Не в тысячу раз же!

среда, 20 мая 2020 г.

Разница в производительности между смартфоном и настольным ПК / Smartphone vs PC performance

Как-то непросто найти в интернете сравнения таких вещей. Хотя есть, конечно, мнение, что "нельзя сравнивать напрямую" и прочее, но хочется именно сравнения и именно напрямую и желательно в одном и том же приложении. Недавно я установил себе Unity и такая возможность мне представилась. Не вдаваясь в подробности скажу, что это бы по сути игровой семпл из Unity SDK с небольшими модификациями. На моем домашнем ПК с процессором Ryzen 5 3400G фреймрейт был около 250 кадров в секунду, а на Galaxy S10e было около 50 кадров в секунду, а на стареньком Galaxy S4 было около 20-25 кадров в секунду. Причем второй смартфон, уже давно не выпускаемый, гораздо ближе к типовому современному смартфону по производительности, чем S10e. То есть можно достаточно уверенно сказать, что типовый смартфон приблизительно в 10 раз медленнее, чем типовый ПК.

пятница, 6 сентября 2019 г.

Узнать код ошибки при запуске команды из python 3 / run shell command on python 3 and get error code

Вместо старой функции popen() лучше использовать более новую check_output(), которая возвращает результат, если код ошибки равен нулю (то есть нет ошибок) или генерирует исключение, из которого можно получить код ошибки и результат работы команды.

import sys
import subprocess

def runCommand(command):
    output = None

    try:
        # run shell command
        output = subprocess.check_output(command, shell=True)
    except subprocess.CalledProcessError as procErr:                
        # handle exception
        print("command \"{0}\" returned error code \"{1}\"".format(command, procErr.returncode))
        errCommandResult = procErr.output.decode(sys.stdout.encoding).strip()
        print("error output: '{0}' ".format(errCommandResult))
        print(errCommandResult)
        return None

    # no exception - just get output of shell command
    successCommandResult = output.decode(sys.stdout.encoding).strip()
    print(successCommandResult)
    return successCommandResult

runCommand("echo hello error & exit 1")
runCommand("dir")


Результат работы будет, например, такой:

D:\projects\SampleApp>python  my.py
command "echo hello error & exit 1" returned error code "1"
error output: 'hello error'
hello error

Volume in drive D has no label.

Volume Serial Number is 72A1-8BB5

Directory of D:\projects\SampleApp

09/06/2019  01:31 PM    <DIR>          .
09/06/2019  01:31 PM    <DIR>          ..
09/03/2019  12:55 PM    <DIR>          bin
09/02/2019  05:17 PM    <DIR>          data
09/06/2019  02:43 PM    <DIR>          make
09/06/2019  03:14 PM     703           my.py
09/02/2019  06:45 PM    <DIR>          prj
09/02/2019  06:12 PM    <DIR>          source
09/02/2019  05:17 PM    <DIR>          tools
               1 File(s)         11,763 bytes
               8 Dir(s)  543,462,584,320 bytes free
D:\projects\SampleApp>